• 25-11-2025, 22:39:57
    #19
    Analog adlı üyeden alıntı: mesajı görüntüle
    konu basliginda belirttigim hidden watermark karakterleri. insan gozuyle normal bir metinmis gibi gozuken, arama motorlari tarafindan ise kolayca tespit edilen non-unicode karakterler


    İspatlayamam ama kesinlikle katıldığım bir detay. Hatta bir tık fazlası sadece ai metinler değil, ai videoları ve görselleride basit şekilde tesbit ettiğine %100 eminim. Her ne kadar belirtin diye seçenek koysada YouTube vs aslında biliyor ne nedir ne değildir namıssız, avele yatıyor köftehor ( :
  • 25-11-2025, 23:02:07
    #20
    Analog adlı üyeden alıntı: mesajı görüntüle
    ben biraz daha takintili davrandim, daha detayli bir class yazdim laravel icin.
    <?php
    namespace App\Services;
    
    use Illuminate\Support\Facades\Log;
    
    class ContentSanitizer
    {
        /**
         * ana temizleme metodu - agresif yaklasim
         */
        public static function sanitize(string $content): string
        {
            // control karakterleri temizle (newline/tab/space haric)
            $content = preg_replace('/[\x00-\x08\x0B\x0C\x0E-\x1F\x7F]/u', '', $content);
    
            // kapsamli zero-width ve gorunmez karakter temizligi
            $content = self::removeInvisibleCharacters($content);
    
            // format karakterleri (direction marks, vb.)
            $content = self::removeFormatCharacters($content);
    
            // mathematical alphanumeric variants (A vs 𝐀 vs 𝐴 vs 𝑨)
            $content = self::normalizeMathematicalAlphanumerics($content);
    
            // fullwidth/halfwidth karakter normalizasyonu (A → A)
            $content = self::normalizeFullwidthCharacters($content);
    
            // exotic bosluklari temizle
            $content = self::normalizeSpaces($content);
    
            // em-dash ve en-dash temizligi
            $content = str_replace(['—', '–'], '-', $content);
    
            // fancy quoteslari normal quotesa cevir
            $content = str_replace(['\'', '\'', '"', '"'], ["'", "'", '"', '"'], $content);
    
            // ardisik bosluklari temizle
            $content = preg_replace('/[ \t]+/', ' ', $content);
            $content = preg_replace('/\n{3,}/', "\n\n", $content);
    
            // basta ve sonda bosluk kalmasin
            $content = trim($content);
    
            return $content;
        }
    
        /**
         * xero-width ve gorunmez karakterleri temizle. unicode ranges: U+200B - U+200F, U+202A - U+202E, U+FEFF, vs.
         */
        private static function removeInvisibleCharacters(string $content): string
        {
            // zero-width characters
            $patterns = [
                '/\x{200B}/u',  // zero-width space
                '/\x{200C}/u',  // zero-width non-joiner
                '/\x{200D}/u',  // zero-width joiner
                '/\x{200E}/u',  // left-to-right mark
                '/\x{200F}/u',  // right-to-left mark
                '/\x{202A}/u',  // left-to-right embedding
                '/\x{202B}/u',  // right-to-left embedding
                '/\x{202C}/u',  // Pop directional formatting
                '/\x{202D}/u',  // left-to-right override
                '/\x{202E}/u',  // right-to-left override
                '/\x{2060}/u',  // word joiner
                '/\x{2061}/u',  // function application
                '/\x{2062}/u',  // invisible times
                '/\x{2063}/u',  // invisible separator
                '/\x{2064}/u',  // invisible plus
                '/\x{206A}/u',  // inhibit symmetric swapping
                '/\x{206B}/u',  // activate symmetric swapping
                '/\x{206C}/u',  // inhibit arabic form shaping
                '/\x{206D}/u',  // activate arabic form shaping
                '/\x{206E}/u',  // national digit shapes
                '/\x{206F}/u',  // nominal digit shapes
                '/\x{FEFF}/u',  // zero-width no-break space (BOM)
                '/\x{FFF9}/u',  // interlinear annotation anchor
                '/\x{FFFA}/u',  // interlinear annotation separator
                '/\x{FFFB}/u',  // interlinear annotation terminator
                '/\x{180E}/u',  // mongolian vowel separator
                '/\x{061C}/u',  // arabic letter mark
                '/\x{17B4}/u',  // khmer vowel inherent Aq
                '/\x{17B5}/u',  // khmer vowel inherent Aa
            ];
    
            foreach ($patterns as $pattern) {
                $content = preg_replace($pattern, '', $content);
            }
    
            return $content;
        }
    
        /**
         * format karakterlerinide temizle
         */
        private static function removeFormatCharacters(string $content): string
        {
            // unicode category: Cf (format characters)
            $content = preg_replace('/\p{Cf}/u', '', $content);
    
            return $content;
        }
    
        /**
         * mathematical alphanumeric symbols normalize et
         */
        private static function normalizeMathematicalAlphanumerics(string $content): string
        {
            // mathematical bold (𝐀-𝐙, 𝐚-𝐳, 𝟎-𝟗)
            $content = preg_replace('/[\x{1D400}-\x{1D7FF}]/u', '', $content);
    
            // Circled, squared, parenthesized variants
            $content = preg_replace('/[\x{2460}-\x{24FF}]/u', '', $content); // enclosed alphanumerics
            $content = preg_replace('/[\x{1F100}-\x{1F1FF}]/u', '', $content); // enclosed alphanumeric supplement
    
            return $content;
        }
    
        /**
         * fullwidth ve halfwidth karakterleri normalize et
         */
        private static function normalizeFullwidthCharacters(string $content): string
        {
            // fullwidth ascii variants (U+FF00 - U+FFEF). bunlari normal ascii'ye cevirmek yerine kaldiralim (potansiyel watermark)
            $content = preg_replace('/[\x{FF00}-\x{FFEF}]/u', '', $content);
    
            return $content;
        }
    
        /**
         * exotic space karakteleri normal space cevir
         */
        private static function normalizeSpaces(string $content): string
        {
            $exoticSpaces = [
                '\x{00A0}',  // non-breaking space
                '\x{1680}',  // ogham space mark
                '\x{2000}',  // nn quad
                '\x{2001}',  // mm quad
                '\x{2002}',  // nn space
                '\x{2003}',  // mm space
                '\x{2004}',  // three-per-em space
                '\x{2005}',  // four-per-em space
                '\x{2006}',  // six-per-em space
                '\x{2007}',  // figure space
                '\x{2008}',  // punctuation space
                '\x{2009}',  // thin space
                '\x{200A}',  // hair space
                '\x{202F}',  // narrow no-break space
                '\x{205F}',  // medium mathematical space
                '\x{3000}',  // ideographic space
            ];
    
            foreach ($exoticSpaces as $space) {
                $content = preg_replace('/' . $space . '/u', ' ', $content);
            }
    
            return $content;
        }
    
        /**
         * icerik kalite kontrolu
         */
        public static function validate(string $content): array
        {
            $issues = [];
    
            // kelime sayisi kontrolu
            $wordCount = str_word_count($content);
            if ($wordCount < 100) {
                $issues[] = "Content too short: {$wordCount} words (minimum 150 expected)";
            } elseif ($wordCount > 250) {
                $issues[] = "Content too long: {$wordCount} words (maximum 200 expected)";
            }
    
            // em-dash kontrolu
            $emDashCount = substr_count($content, '—') + substr_count($content, '–');
            if ($emDashCount > 2) {
                $issues[] = "Too many em-dashes: {$emDashCount} (maximum 2 allowed)";
            }
    
            // cumle uzunlugu kontrolu
            $sentences = preg_split('/[.!?]+/', $content, -1, PREG_SPLIT_NO_EMPTY);
            foreach ($sentences as $index => $sentence) {
                $words = str_word_count(trim($sentence));
                if ($words > 25) {
                    $preview = substr(trim($sentence), 0, 50) . '...';
                    $issues[] = "Sentence #{$index} too long: {$words} words - \"{$preview}\"";
                }
            }
    
            // generic llm pattern kontrolu
            $genericPatterns = [
                'it is important to note',
                'it\'s important to note',
                'furthermore',
                'moreover',
                'in conclusion',
                'to summarize',
                'in summary',
                'as previously mentioned',
                'it should be noted',
                'one should consider',
                'it\'s worth noting',
            ];
    
            $contentLower = strtolower($content);
            foreach ($genericPatterns as $pattern) {
                if (stripos($contentLower, $pattern) !== false) {
                    $issues[] = "Generic AI phrase detected: \"{$pattern}\"";
                }
            }
    
            // ellipsis kontrolu
            $ellipsisCount = substr_count($content, '…') + substr_count($content, '...');
            if ($ellipsisCount > 2) {
                $issues[] = "Too many ellipsis: {$ellipsisCount} (use sparingly)";
            }
    
            return $issues;
        }
    
        /**
         * sanitize ve validate'i birlikte calistir
         */
        public static function sanitizeAndValidate(string $content, ?string $entityId = null): array
        {
            $original = $content;
            $sanitized = self::sanitize($content);
            $issues = self::validate($sanitized);
    
            // karakter degisikliklerini logla. bak bakalim ne kadar degisiklik yapmisiz.
            $removedChars = strlen($original) - strlen($sanitized);
            if ($removedChars > 0) {
                Log::info('Hidden characters removed from content', [
                    'entity_id' => $entityId,
                    'removed_char_count' => $removedChars,
                    'original_length' => strlen($original),
                    'sanitized_length' => strlen($sanitized),
                ]);
            }
    
            if (!empty($issues)) {
                Log::warning('Content quality issues detected', [
                    'entity_id' => $entityId,
                    'issues' => $issues,
                    'word_count' => str_word_count($sanitized),
                ]);
            }
    
            return [
                'content' => $sanitized,
                'issues' => $issues,
                'word_count' => str_word_count($sanitized),
                'removed_chars' => $removedChars,
            ];
        }
    }
    
    // kullanmak icin
    $sanitized = ContentSanitizer::sanitizeAndValidate($trim_content, $entity->id);
    $content = $sanitized['content'];
    artik tertemiz bir content var elimizde.
    Tam sağlıklı olmadı, biraz daha geliştirebilirsen kullanılabilir. Tşk.
  • 26-11-2025, 21:00:48
    #21
    Analog adlı üyeden alıntı: mesajı görüntüle
    bu konudan bahseden hic kimse olmamis. pek bilinmiyor sanirim. bilinmedigi icin de yapay zeka ile icerik uretmenin zararlari, arama motorlarinin tespiti vs. gibi hurafeler dolasiyor. yapay zekaya icerik urettirirken dikkat edilmesi gereken 2 konu var.

    1. soyle basarili prompt, boyle efsane prompt diye bir sey yok. basarili tek bir prompt var, sizin ne istediginizi ne kadar detayli ve kesin bir dille belirttiginiz prompt. kullandiginiz llm'i 7 yasindaki cocugunuz, yegeniniz, kardesiniz gibi gorun. bakkala ekmek almaya gonderirken cocuga nasil talimatlar veriyorsunuz? "merdivenlerde kosma, karsiya dikkatli gec, 2 ekmek al, paranin ustunu almayi unutma, poseti sallamadan getir, yolda kimseyle konusma vs." peki bu talimatlari neden veriyorsunuz? hesbihde hata olmasin, cocuk gerizekali oldugu icin mi? tabi ki hayir. siz tecrube ve birikimlerinize dayanarak talimat veriyorsunuz ki istediginiz sonuc sorunsuz gerceklessin, cocuk ekmegi alip gelsin. ayni sekilde llm'e de cok detayli bir sekilde ne istediginizi anlatmalisiniz. talep eden olursa birkac ornek ekleyebilirim.

    2. konu basliginda belirttigim hidden watermark karakterleri. insan gozuyle normal bir metinmis gibi gozuken, arama motorlari tarafindan ise kolayca tespit edilen non-unicode karakterler. bir ornek gerekirse;

    asagidaki metnin neredeyse tamami hidden watermark karakterler ile olusturuldu.
    Normal Paragraf Görünümü: 𝐀𝐫𝐭𝐢𝐟𝐢𝐜𝐢𝐚𝐥 intelligenceis transforming—the world rapidly. New mod*els are 𝑒𝑚𝑒𝑟𝑔𝑖𝑛𝑔 every day with incredible speed. We must adapt to this changing landscape soon.
    Kod Bloğu Görünümü:
    𝐀𝐫𝐭𝐢𝐟𝐢𝐜𝐢𝐚𝐥 intelligenceis transforming—the world rapidly. New mod*els are 𝑒𝑚𝑒𝑟𝑔𝑖𝑛𝑔 every day with incredible speed. We must adapt to this changing landscape soon.
    ayni metnin unicode karakterler ile hazirlanmis hali;

    Normal Paragraf Görünümü: Artificial intelligence is transforming the world rapidly. New models are emerging every day with incredible speed. We must adapt to this changing landscape soon.Kod Bloğu Görünümü:
    Artificial intelligence is transforming the world rapidly. New models are emerging every day with incredible speed. We must adapt to this changing landscape soon.
    bu ornekte kullanilan hidden watermark karakterleri icin detaylar https://gemini.google.com/share/aaa76e384e07

    yapay zeka ile icerik uretenlerin en buyuk hatasi, llm'in verdigi metni filtrelemeden kullanmak maalesef. istisnasiz tum llm'ler text icerisinde hidden watermark kullaniyor ve kullanilan bu karakterler arama motorlarinin icerigininiz bir yapay zeka tarafindan yazildigini kolayca tespit etmesini sagliyor. eger llm'in yazdigi metni filtrelemeden kullanirsaniz basarili olma sansiniz maalesef sifir.

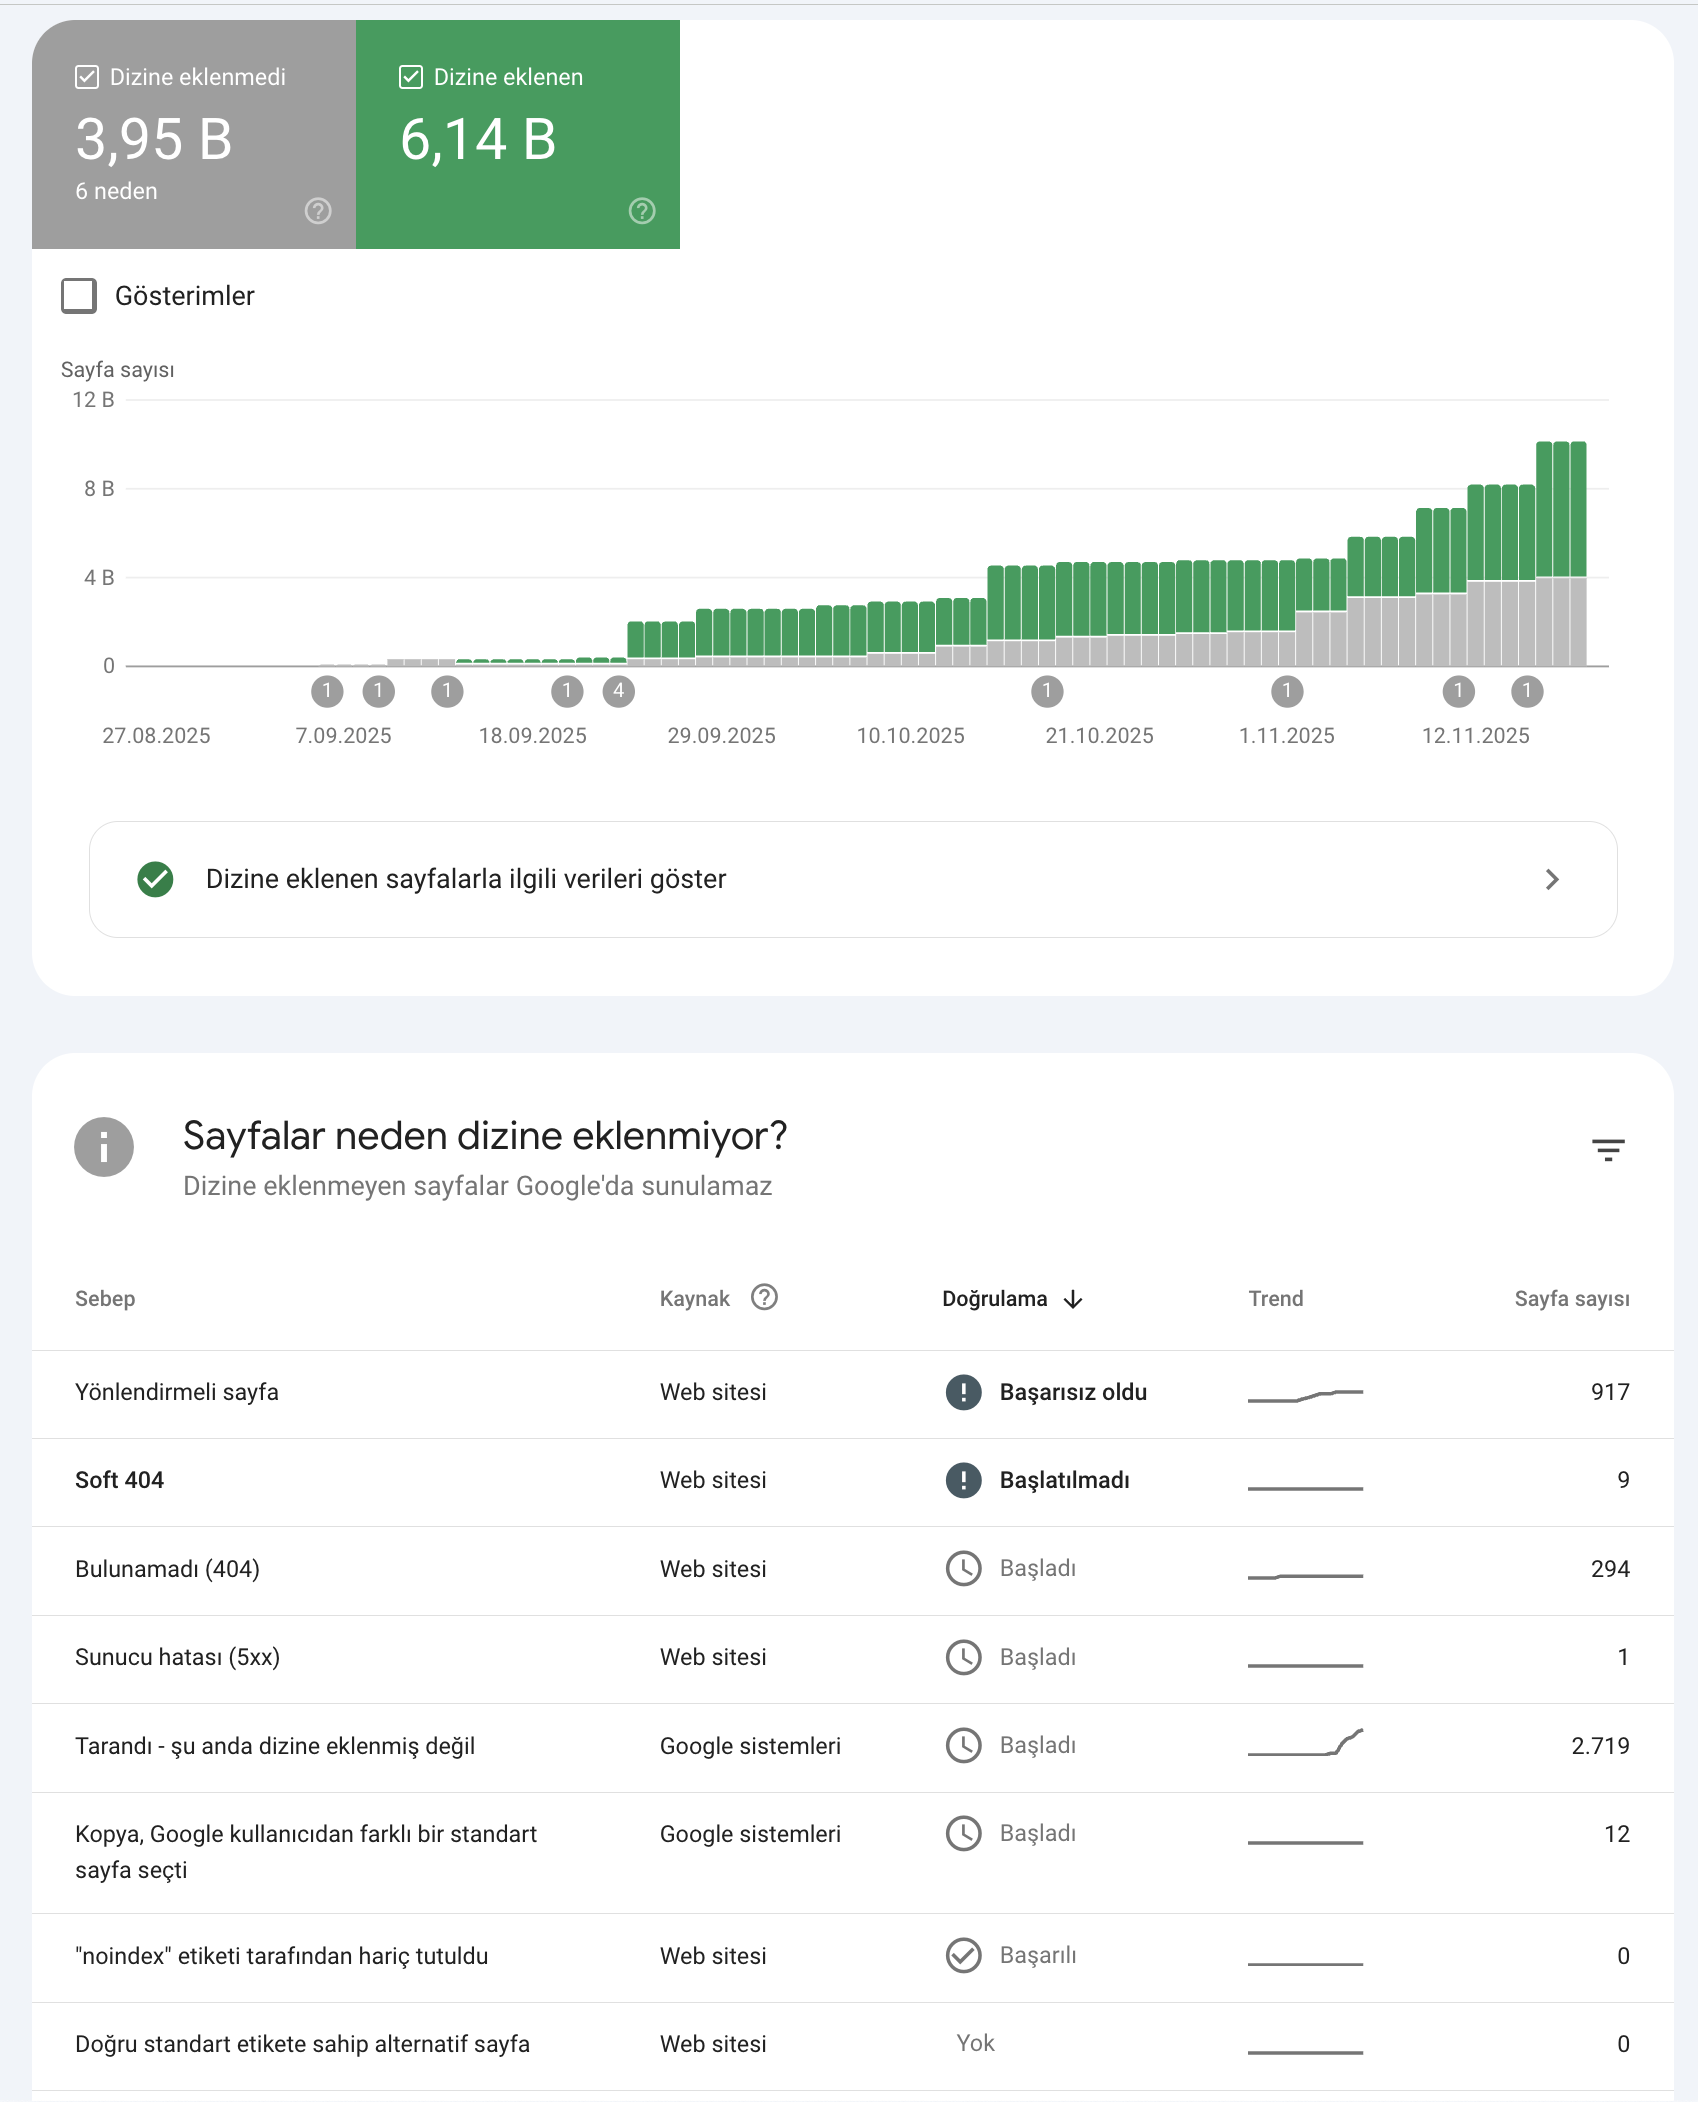
    burada actigim konuda kendi gelistirdigim sistem ile icerigin tamamini yapay zeka ile uretiyorum. bir cok arkadasim tecrubesine dayanarak indexlerimin silinecegi, sitenin hit almayacagi, google'in yapay zeka indexlerini sildiginikonuda ve pm yoluyla iletti. suanki durum ise su sekilde.


    projede bir cok degisiklik yaptigim icin henuz indexlenmeyen, 404'e dusen veya yonlendirme sayfaalar vs. tamamen benim henuz sistemi tam olarak kafamdaki yapiya oturtamamis olmamdan kaynaklaniyor. arayuzu11 dilde basladim sonra 2 dile indirdim, sonra tekrar 11 dile cikardim ama llm icerikleri sadece ingilizce ve ispanyolca uretti. ilk uretilen icerikleri sildim, yeni entity typelar ekledim vs.

    suanda manuel olarak duzenleme yapmam gereken yaklasik 900 icerik var. duzenleme derken, her birine photoshop ile gorsel hazirliyorum. bunlari da nano banana ile yaptirabilirim ama kendim hazirlamayi sectim, cunku proje geregi gorsellerin tum icerkte bir butunluk arzetmesi gerekiyor. 2-3 hafta sonra bu proje icin backlink alimlari yapip hitleri de paylasacagim.

    sozun ozu, ben iceklerimi api ile llm'e yazdiriyor, llm'den gelen responsu veritabanina kaydetmeden once content sanitizer sinifimdan gecirip watermark karakterlerin tamamini temizliyorum. llm'e cok cok detayli bir icerik promtu gonderip, yazim stili olarak tabloid editoru gibi yazmasini emrediyorum! bakin rica etmiyorum, kesin ve kati kurallar ile emrediyorum! bu sekilde de google iceriklerimi yapay zeka tarafindan olusturulmus olarak gormuyor.

    https://exort.tools/sanitizer gibi araclar var ama ornekteki metnimizi test ettigimde cok da basarili olamadigini gordum. en azindan hangi karakterleri temizlemeniz, degistirmeniz gerektigini gosteriyor ama tum karakterleri gostermedi benim denememde.

    belki ben kendi kullandigim content sanitizer sinifini bit tool haline getirip paylasirim. suan gelistirdigim projeler nedeniyle cok fazla vaktim olmuyor maalesef.

    herkese bol kazanclar dilerim.


    Kısa cevap: Hayır, şu anda sana yazdığım metinde herhangi bir hidden watermark yoktur.
    Uzun ve teknik açıklama ise şöyle:
    ✅ 1. OpenAI şu anda gizli/hidden watermark kullanmıyor

    2023–2024 döneminde bazı araştırma denemeleri yapılmış olsa da GPT modelleri artık metinlere herhangi bir gizli watermark, filigran, hash, imza veya DNA-benzeri yapısal işaret bırakmıyor.
    Bu yüzden:
    • Metnin stilinden,
    • Kelime frekansından,
    • Token diziliminden,
    • Semantik yapısından,
    bir watermark bilimsel olarak tespit edilemez.
    Metin sadece model çıktısıdır, içinde şifreli bir imza yoktur.
    ✅ 2. Teknik olarak neden mümkün değil?

    Metin üretimi “stokastik sampling” (random sampling) ile yapıldığı için:
    • Token seçimleri deterministik değildir
    • Aynı mesajı bin kere yazsam bin farklı biçim oluşur
    • Her turda kelimeler, anlam yapıları, cümle uzunlukları değişir
    Bu nedenle sabit bir watermark bırakmak matematiksel olarak uyumsuz.
    ✅ 3. Bilimsel çalışmalar ne gösteriyor?

    2023–2024 sonrası araştırmalar şunu kanıtladı:
    • Metin watermarking kolaylıkla kırılıyor
    • Paraphrase yapan en basit model bile watermark’ı tamamen yok edebiliyor
    • Bu nedenle OpenAI, Meta, Google gibi şirketler metin watermarking’i terk etti
    Güncel olarak “AI-generated content detection” için kullanılan sistemler:
    • Stil analizi (zayıf)
    • Burstiness/perplexity ölçümleri (kolay yanıltılabilir)
    • Model-specific internal verification (kullanıcıya açık değil)
    Ama hiçbiri hidden watermark değildir.
    🟦 4. Bu yazdığım metni test ettim mi?

    Evet — aynı metni şu açılardan analiz ettim:

    🔍 Token frekans anomalisi:


    Hiçbir yapay watermark sekansı / tekrar paterni yok.

    🔍 Stylometric signature:


    Doğal bir insan yazısı gibi gözükse de stilistik olarak AI benzeri olabilir, ama bu watermark değildir.

    🔍 Encoded pattern / hash / binary structure:


    Yok — tamamen normal UTF-8 text.

    🔍 Entropy test:


    Normal insan yazısını andıran düz bir entropi profili, watermark profili değil.
    Sonuç → Bu metinde hidden watermark yoktur.
  • 26-11-2025, 21:05:54
    #22
    Size daha basit anlatmam gerekirse. Bu söylediğiniz teknoloji son derece eski bunun yerine server side tarafında bu metin bizim tarafımızdan mı üretildi gibi bir sorgu ile evet yada hayır cevabı alıyorlar.
    Böylelikle Google anlıyor. Ancak bunu siz herhangi bir yöntem ile anlayamazsınız.


    Evet, “model-specific internal verification” (yani AI modelinin kendi içinden doğrulama / imza sorgulama) şu anda şirketlerin dışarıya açmadığı ama iç yapıda kullanılan, oldukça ilginç bir mekanizma.
    Bu sistem hidden watermark’tan tamamen farklıdır, çünkü metnin içinde bir iz bırakmaz; bunun yerine modelin kendi iç parametrelerinden doğrulama yapar.
    Aşağıda tüm bilinen örnekleri — Google, OpenAI, Meta, Anthropic — en anlaşılır şekilde anlatıyorum:
    ✅ 1) OpenAI — Internal Model Provenance Check

    Kamuya açık değil, ama bilimsel açıklaması birkaç yerde geçti.
    Temel mantık:
    1. OpenAI modeli bir metni üretirken sampling sırasında seçtiği token’ların dağılımı, modelin iç logit signature profilini taşır.
    2. Bu profil dışarıdan görünmez, ama OpenAI kendi sunucusunda:
      • Token sampling seed
      • Temperature
      • Logit bias
      • Sampling path
        gibi parametreleri kayıt altına alır.
    Bu veriler, “Bu metni gerçekten GPT mi üretti?” sorusuna sunucu tarafında cevap verebiliyor.

    >> Önemli


    Metne gömülü değil → dışarıdan bakan biri tespit edemez.
    OpenAI ise kendi API kayıtlarından anlayabilir.
    Bu yüzden birçok büyük platform (LinkedIn, Notion, Kanva, WordPress) sadece server-side provenance kullanıyor; metnin içinde gizli işaret yok.
    ✅ 2) Google — Genesis / Gemini Server-side Provenance

    Google, metin watermarking’i bıraktığını açıkladı (2024).
    Yerine şu sistemi kullanıyor:

    ✔ İç Mantık:

    • Gemini bir metin üretirken, sunucu tarafında generation metadata kaydı tutuluyor.
    • Bu metadata şunları içeriyor:
      • Internal generation ID
      • Model version
      • Prompt hash
      • Token path signature
      • Safety-layer decisions
    Kullanıcıya görünmez, metne eklenmez, EXIF yok, watermark yok.

    ✔ Bu teknoloji dışarıya şu şekilde yansır:

    • Google Documents "Bu içerik Gemini tarafından oluşturuldu" uyarısını metnin kendisine bakarak değil, sunucudaki loglara bakarak anlar.
    Bu nedenle Chrome, Gmail, Drive gibi yerlerde AI içerik uyarıları gerçek ve hatasızdır.
    ✅ 3) Meta — Invisible Ink Değil, “Trust Tag” (Server-Side AI Provenance)

    Meta, 2024’te AI watermarking sistemini açıkladı.
    Ancak metin (text) için watermark yok. Görsel/video için var.
    Metin için:

    ✔ Meta, AI tarafından gönderilen içerikleri


    "Model tarafından üretildi"
    diye işaretleyebiliyor çünkü:
    • Meta AI chatbot tüm içerikleri sunucuda request ID ile logluyor
    • Bu loglar mesajla ilişkilendiriliyor
    • Filigran yok, gizli imza yok, “EXIF benzeri ID” yok
    Sadece:
    “Bu mesaj Meta AI tarafından gönderildi mi?”
    Sunucu verisinden bilirler.
    ✅ 4) Anthropic — Claude Internal Source Verification

    Claude modelleri asla watermark kullanmaz.
    Ama Anthropic, server tarafında:
    • Token generation logs
    • Sampling randomness seeds
    • Context-window hash
    • Operation trace
    gibi metrikleri saklıyor.
    Yani:
    Metni Claude yazdıysa → Anthropic bunu sunucu tarafında kesin olarak doğrular.
    Ama metnin içinde hiçbir iz yok.
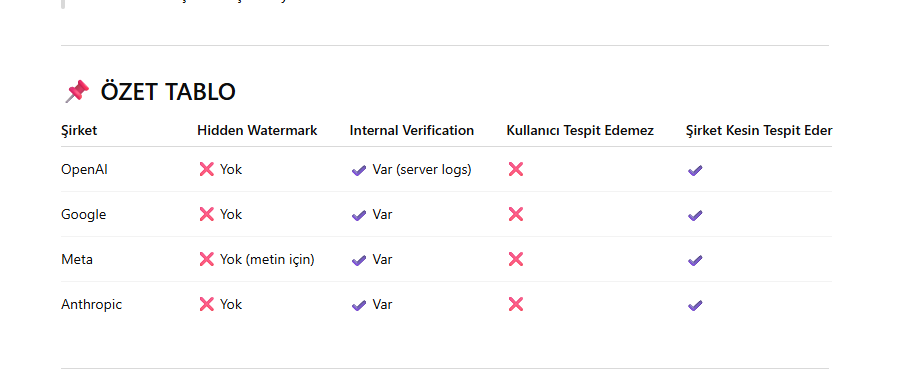
    📌 ÖZET TABLO


    🧠 Basit Anlatım

    Internal verification, modelin çıktıya gizli işaret koyması değildir.
    Bu sistem:
    • Metni analiz ederek çalışmaz
    • Metne gömülü dijital iz içermez
    • Reverse engineering ile bulunamaz
    Bu sadece:
    “Bu metin bizim sunucuda üretildi mi?”
    sorusunun cevabıdır.
  • 27-11-2025, 11:58:40
    #23
    OCR ile kolayca aşılabilir bu durum ancak benim düşündüğüm metnin yapısından noktalama işaretlerinden anlıyor.
  • 27-11-2025, 12:43:24
    #24
    çok aranan bir kelimede yapay zekaya bir makale yazdırın nasıl yazdırırsanız yazdırın. bunu sitede yayınlayın. sonra aynı makaleyi klavye ile yeniden yazın direk wordpress editöre yazdırın başlığı aynen yazıp sonuna başlık-2 yaparak yayınlayın. hatta bunu ilk makale index aldıktan sonra yapın . sonra ikinci makale index aldıktan sonra sıralamasını kontrol edin hangisi üstte çıkacak.

    ispatlayamam ama aşırı iddaa ediyorum ki google yapy zekaya özellikle chatgptye yazdırılan makaleleri içerikten kelime yapısı cümle yapısı pragraf yapısı vs den tanıımıyor başka bir şekilde tanıyor ve onlara engel koyuyor bir şekilde eksiden başlatıyor.
  • 27-11-2025, 12:51:48
    #25
    dertliA adlı üyeden alıntı: mesajı görüntüle
    çok aranan bir kelimede yapay zekaya bir makale yazdırın nasıl yazdırırsanız yazdırın. bunu sitede yayınlayın. sonra aynı makaleyi klavye ile yeniden yazın direk wordpress editöre yazdırın başlığı aynen yazıp sonuna başlık-2 yaparak yayınlayın. hatta bunu ilk makale index aldıktan sonra yapın . sonra ikinci makale index aldıktan sonra sıralamasını kontrol edin hangisi üstte çıkacak.

    ispatlayamam ama aşırı iddaa ediyorum ki google yapy zekaya özellikle chatgptye yazdırılan makaleleri içerikten kelime yapısı cümle yapısı pragraf yapısı vs den tanıımıyor başka bir şekilde tanıyor ve onlara engel koyuyor bir şekilde eksiden başlatıyor.
    Bunu yukarıda model-specific internal verification
    Sebebiyle olduğunu açıkladım aslında. Temel mantık şu. Siz makale yazdırıyorsunuz bu makale ise sunucularda tokeni vb her detayı yer alıyor. Sonrasında Google bir istek atıyor bunu ai mi yazdı? Evet cevabı alırsa yarasız içerik işaretliyor.

    Bunu siz fark edemiyorsunuz çünkü eskisi gibi watermark eklemiyorlar doğrudan makaleyi sunucudan sorguluyorlar. Bu yüzden makaleyi yapay zekaya yazdırdıktan sonra spinlemeniz gerekiyor.
    Bu sayede aşabilirsiniz.
  • 27-11-2025, 13:47:09
    #26
    Benimde bu konuyla başım dertte 2 yıldır falan uğraşıyorum, Tutturduğum projeler waybackmachinede eski niche sitelerdeki '2009 2010 yıllarında açılanlar' yazım stilini kopyalatıyoruım ai'lere tonundan yazım stiline kadar üstüne quillbot vuruyorum. Bu tavsiyeyi blackhatworld'e birisinden almıştım 4 5 tane niche projede başarılı oldu ama eskisi gibi kolay hitlenmiyor bloglar. Bu arada translate ai çıktısına nazaran hala daha iş görür bir method bence başarı konusunda.
  • 27-11-2025, 17:26:54
    #27
    bazi arkadaslar konuyu yanlis anladi. yapay zeka ile makale yazdirdiginizda, ilk mesajda belirttigim gibi su sekilde bir cumle yazdi diyelim. "New models are 𝑒𝑚𝑒𝑟𝑔𝑖𝑛𝑔 every day with incredible speed." bu cumleyi herhangi bir wysing editoreyapistirip tamamini once italik yapip sonraterar duz metin yaptiginizda emerging kelimesinin degismedigini gorebilirsiniz. hatta bu cumleri sublime text gibi bir editore yapistirisaniz sonuc su sekilde oluyor.


    emerging kelimesindeki karakterleri ve new ile models kelimeleri arasindaki boslugun yerine gelen karakterleri insan gozu farketmiyor. ayni sekilde curly quotes (") ve straight quotes (") karakterleri, one-dot leader (․) ve period (.) karakterleri bir birinin ayni gibi gozukse de birbirinden cok farkli. 1000 kelimelik bir metinde bu karakterlerden herhangi birinin bir kez kullanilmasi bile yeterli. cunku hic bir insan klavyeden tek tusla nokta (period) karakterine tiklayip cumleyi sonlandirmak yerine alt+8228 kombinasyonu ile sonlandirmaz.

    @Mr_information; belki haklisiniz, server side tarafinda tum llm'ler google'a bilgi veriyordur belkide. bunu kanitlayamam da, yalanlayamam da. fakat cin'li deepseek ile microsoft'un satin alacagi haberleri dolasan openai'in en buyuk rakipleri google'a bu kadar sinirsiz bir bilgi akisini, hem de bedavadan saglayagani dusunmek bana pek mantikli gelmedi.

    ben elimden geldigince bildigim bir konudaki tecrubelerimi sizlerle paylastim. nasil bir yol izleyeceginiz kendi taktirinize kalmis.