Local llm gücünü artırmak.
8
●296
- 13-09-2026, 22:58:04Arkadaşlar merhaba bir kaç aydır üzerinde çalıştığımız saas projemize bir llm bağlama noktasına geldik. Proje YouTubeda bulunan kaynakların transkript edilip, anlayıp hafızaya yazma üzerine. Localde çalışacak elde edilen veriler ile çalışılacak. qwen 2.5 14b ve deepseek R1 8b Mixture-of-Agents (MoA) tekniği ile 5070 ekran kartı 16gb ramde çalışıyor ama llmin gücünü artırmak istiyorum. Airllm diye bir repo buldum ancak projeme uymadı. Donanımı değiştirmeden llmde gücü nasıl artırabilirim ?
- 14-09-2026, 12:22:05İşime yarayacak gibi duruyor. Çok teşekkür ederim.enfyn adlı üyeden alıntı: mesajı görüntüle
- 14-09-2026, 16:32:12@ROPZ;
localdeki 14B ve altındakilerden yeterli performans alamazsın ve "analiz et" gibi çok geniş ifadesi olan bir prompt için "hatayı söyle düzelteyim" gibi bir kaba cevap alabilirsin.
1) Bunun sebebi ise, ufak boyutlu llm lerde beşeri iletişime ait yapının olmaması. Online llm modellerinde promptlar önce bir filitre kısmında geçirilir ve önceki promptların veya "analiz et" gibi kelime için tanımlı detaylı şablonlara aktarılır. o şablonlar ilk önce okuduğu dosya mimarisine göre yönlendirilir.
2) bu llm modellerinde limitli parametre bulunur. İsteğinizi tekil ve çok net ifade etmeniz gerekir. "index.html" dosyasındaki buton1 yazısının fontunu 14 ve rengini bold yap gibi çok net odaklı prompt vermeniz gerek.
O şekilde tekil ve odalı yapmak yerine, "yazi_stili.md" dosyasina göre tüm dosyaları incele ve düzelt ifadenizi anlamaz ve yorumlayamaz.
hardness gibi farklı agent yapıları ne kadar düzeltiyor henüz test etmedim. Mümkün mü ? evet ama online modelleri düşününce hepsini yapamaz demek daha net olabilir.
Metcut GPU'nuzu performanslı kullanmak için ne yapmanız gerek?
Online llm modellerine amacınızı belirtin. Sizinle uzun bir test işlemine girecek. Benbu işlemi gemini ve gpt ile çok yaptım. Adım adım, her komut sonucunu onlarile paylaşarak tuning işlemi yapıldı. Mevcut gpu dan alınabilecek en iyi sonuca odaklanıldı.
Ama A6000 BW - 96GB bile kullansanız, en basit online modelin iletişim ve kısa prompt "analiz et" mantığına erişemez. Yapabilirsiniz. Ama nasıl ? "analiz et" gibi bir prompt için bir dosya çağırmasını ve oradaki tüm işlemleri sırası ile yaptırıp ekrana sonuçları yazmasını sağlayabilirsiniz.
Ama şunu unutmayın.
Localde kullanabileceğiniz max LLM modeli için max context boyutu nedir ? 8k - 16k ?
Peki online modellerdeki context boyutları ? bağlamı unutmadan sonuç üretmesi ve her analiz ettiği dosyaya ait sorunları cache saklama süresi ?
Extra teknik bir bilgi :
16GB gpu ya sahipsiniz.
bunun 1GB ını OS kullandığını kabul edelim. Kaldı 15GB.
GPU için kullanabileceğiniz en iyi LLM boyutu max 14GB olmalı. Aksi halde cache'lenecek bir alan kalmaz. Cache kısmını RAM'e yükleyim derseniz, mümkün. Ama sürekli iki alan arasında bir veri transferi anında gecikme olacak. LMStudio'nun bu tür bir ayarı mevcut idi. Yeni sisteme geçtiler ne değişti incelemedim.
Sistemizden bulunması gereken ram için teorik değer +2X dir. Yani 16VRAM var ise en az 32GB ram kullanmanız size fayda sağlar.
Online modeller ile kendi local sisteminiz kıyas etmeyin.
Onların mainboard yapısı çok hızlı ve cache yapısı için entreprise nvme diskler kullanılıyor. Yani daha önce başkasının veya senin sorduğun kodlar ile bilgiler oradan geliyor. Her prompt her zaman LLM model dosyasına gitmiyor.
Bunun şu dez avantajı var. Halisünasyon dediğimiz olayın bir sebebi de buradan kaynakların. LLM modeli parametre sayısı arttıkça, sorunuza ait cevap için alternatifler fazla olacak ve ilk denk geldiği benzer cevabı size sunacak. İlk gelen cevap da genelde bu cache yapısından dönecek.
Başarılar - 14-09-2026, 22:54:14Hocam öncelikle mesajınız için çok teşekkür ederim. Hocam kullandım 14b ve senkron kullandığım 8b ile bir saatlik videoları parça parça bölüp anlamlı çıkarımlar elde ediyorum. Halüsinasyon oluyor kaçırdığı oluyor. Online çözümler arayacağımtosunpasa adlı üyeden alıntı: mesajı görüntüle
- 15-09-2026, 03:09:00@ROPZ;
ya arkadaş moralimiz bozdunuz.
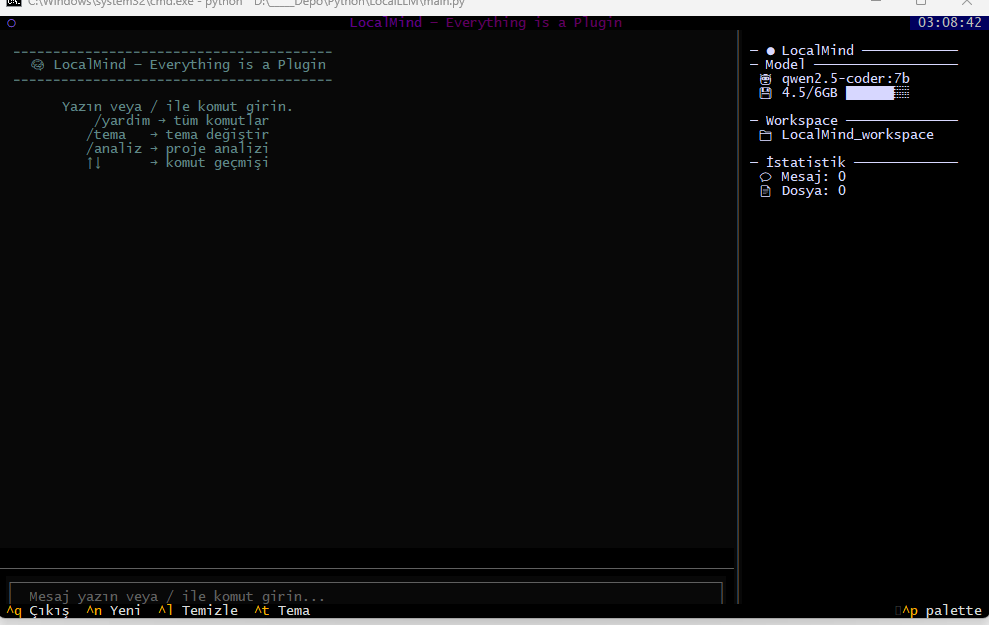
Oturdum ollama ile çalışan bir TUI yazmaya başladım.
Opencode ve claude code gibi TUI lerin özelliklerini import ediyorum.
Basit bir pyhton ile terminalde hesap makinesi kodu oluşturma aşamasını yaptırdım ama sorun "beşeri iletişim" kısmı.
Onun için oldukça uzun bir dönem gerekiyor.
ModelFile yapısı entegre edeceğim.
Çok uzun bir süreç ama basit de olsa localde (asla online performansı olamaz) işlem yapacak bir yapı hedefindeyim
bakalım ortaya ne çıkacak