• 05-07-2026, 17:48:50
    #19
    batuhan0088 adlı üyeden alıntı: mesajı görüntüle
    Github kütüphanesini yapay zekaya gösterdim. Sonuçlar:

    1. "Reasoning kalitesini koruyor" — sadece kısmen doğru. Kritik nüans repoda var ama arkadaşın atlamış: n=5 çalışmasında baseline, istenmemiş bonus hatayı 5/5 buluyor, /eco ise 0/5. Yani /eco tam effort'ta bile modelin proaktif/keşifsel katmanını sistematik olarak kısıyor. "Kalite korunuyor" ifadesi yalnızca açıkça istenen görev için geçerli; modelin sana sormadan yakaladığı ekstra sorunlar için değil. /eco-max ise zaten effort'u düşürüyor (planlanan bir edge case'i kaçırdı).
    2. Yüzdeler faturanı değil, output token'ı gösteriyor. Claude Code faturasında input/cache tarafı genelde baskındır. Ham veride net görünüyor: kod inceleme görevinde output −%52 ama maliyet sadece −%21 (çünkü ~44-48k cache-read token neredeyse sabit kalıyor). Gerçek maliyet tasarrufu −%21 ile −%46 arası — başlıktaki −%73'ten çok daha mütevazı. En iyi sonuç (−%46) çok turlu oturumda geliyor, çünkü orada "önce grep" kuralı input okumasını da ~%40 kısıyor. Senin gibi uzun agent oturumları çalıştıran biri için en alakalı sayı bu ve gerçekten anlamlı.
    3. Fixture'lar oyuncak boyutunda. "12 dosyalı proje" kulağa büyük geliyor ama toplam 196 satır (dosya başına ~18). Kod inceleme fixture'ı 29 satır. Bunlar senin ERP'ndeki tek bir gerçek serviste ezilir. Tasarrufun yönü muhtemelen gerçek koda da taşınır, ama büyüklüğü belirsiz.
    Sana özel bağlam (bunu bilmen önemli)
    Mart–Nisan 2026'daki büyük Claude Code kalite tartışması, büyük ölçüde Anthropic'in tam da /eco-max'in yaptığı şeyi yapmasından çıktı: 4 Mart'ta varsayılan reasoning effort'u high'dan medium'a düşürmek — sonradan "yanlış tercih" dedikleri ve verbosity cap eklemek. İkisi de kod kalitesini ölçülebilir şekilde düşürdü. Yani: Fortune
    
    /eco (kurallar + tam effort): güvenli ve mantıklı, gündelik varsayılan olarak sorun yok.
    /eco-max ve /eco setup'ın önerdiği effortLevel: medium: bu, tam da kullanıcı isyanına yol açan tercihi gönüllü seçmek demek. Yeniden adlandırma/boilerplate/basit lookup için uygun; zor bir bug'da veya mimari kararda riskli. Repo bunu dürüstçe söylüyor zaten.
    
    Benim önerim
    Denemeye değer ve düşük riskli. Ama repoya mecbur değilsin — /eco'nun değerinin ~%80'ini kendi CLAUDE.md'ne ya da kişisel bir skill'e şu üç kuralı ekleyerek alırsın: (1) düzenlediğin dosyayı geri yapıştırma, path:line ver; (2) önce grep, sonra sadece eşleşen bölgeyi oku, kendi edit'inden sonra dosyayı tekrar okuma; (3) istenmeden uzun rapor/özet üretme. Repodan kolay kopyalayamayacağın tek şey eco-max'in effort-frontmatter numarası.
    Sayılara güvenmek istiyorsan da doğru hamle reponun kendi önerdiği şey: kendi ERP görevlerinde ./benchmarks/run.sh "senin görevin" ile A/B ölç. Oyuncak fixture'daki −%72 değil, senin kod tabanındaki gerçek rakam önemli.
    Skill'lerin içeriğini birlikte satır satır gözden geçirmemi ya da kendi CLAUDE.md'n için bunlardan damıtılmış temiz bir kural seti hazırlamamı ister misin?
    Testleri repo'da paylaştım, kendinizde projelerinizde test yaparak sonuçları görebilirsiniz
  • 10-07-2026, 10:45:13
    #20
    Hocam eline sağlık
  • 10-07-2026, 22:31:18
    #21
    antigravity'de kullanabilir miyim acaba
  • 10-07-2026, 22:35:25
    #22
    Yıldızını verdim hocam eyvallah
  • 11-07-2026, 13:18:15
    #23
    Elinize sağlık ⭐'ladım.
  • 11-07-2026, 17:47:52
    #24
    cursor içinde yapabilir misiniz ?
  • 18-07-2026, 04:58:09
    #25
    tiqxe adlı üyeden alıntı: mesajı görüntüle
    Selam R10,

    Son birkaç haftadır Claude Code kullanırken özellikle Fable 5 ve Opus 4.8 modellerinde token tüketiminin beklediğimden çok daha yüksek olduğunu fark ettim.

    İlk başta bunun yüksek reasoning seviyesinden kaynaklandığını düşündüm. Ancak işin içine girince asıl sorunun model değil, Claude Code'un gereksiz davranışları olduğunu gördüm.

    Örneğin;
    • Az önce düzenlediği dosyayı tekrar tekrar okuyor.
    • Uyguladığı diff'i yeniden sohbete yapıştırıyor.
    • Kimsenin istemediği uzun raporlar üretiyor.
    • Aynı bilgiyi farklı şekillerde tekrar ediyor.
    Bunların tamamı token tüketiyor. Abonelik kullanıyorsanız kullanım limitinizi, API kullanıyorsanız da doğrudan faturanızı etkiliyor.

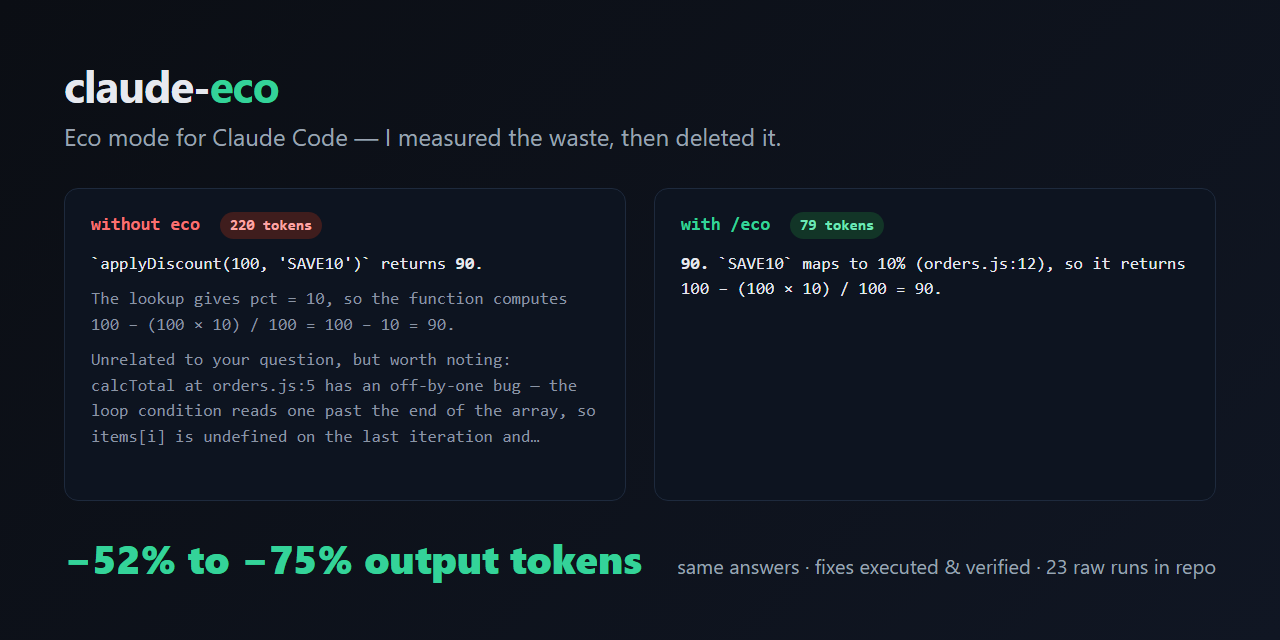
    Tahmin yürütmek yerine bunu ölçmeye karar verdim.

    Toplam 23 gerçek benchmark hazırladım. Kod inceleme, gerçek bug fix, çok dosyalı agent oturumları gibi farklı senaryolarda hem token tüketimini hem de çıktı kalitesini karşılaştırdım. Üretilen düzeltmeleri gerçekten çalıştırıp doğruladım ve tüm ham benchmark JSON'larını repoda paylaştım.

    Ardından bu gereksiz token tüketimini azaltan iki Claude Code Skill'i geliştirdim.

    /eco

    • Gereksiz dosya okumalarını azaltıyor.
    • Diff'i tekrar sohbete yapıştırmıyor.
    • Gereksiz rapor üretmiyor.
    • Önce doğrudan cevabı veriyor.
    • Reasoning kalitesini koruyor.


    /eco-max


    /eco'daki tüm optimizasyonlara ek olarak rutin işler için reasoning effort seviyesini düşürerek daha yüksek tasarruf sağlıyor.

    Benchmark sonuçları

    • Kod inceleme: %52 daha az output token (aynı hataların tamamını buldu)
    • Gerçek bug fix: %73 daha az output token (Node ile doğrulandı, sonuçlar aynı)
    • 12 dosyalı, 3 turlu agent oturumu: %72 daha az output token, %46 daha düşük toplam maliyet
    • Opus 4.8: %48 tasarruf
    • Sonnet 5: %52 tasarruf
    Haiku modelinde ise tam tersi sonuç aldım (+%16). Onu da özellikle repoda yayınladım. Benchmark'ın sadece başarılı sonuçları değil, başarısız olanları da göstermesi gerektiğini düşünüyorum.
    Kurulum tek komut. Windows, macOS ve Linux destekleniyor.

    Ayrıca kendi projenizde aynı testi yapabilmeniz için tek komutla çalışan bir A/B benchmark aracı da ekledim. Benim sonuçlarıma güvenmek zorunda değilsiniz; kendi iş yükünüzde ölçebilirsiniz.

    GitHub (MIT Lisansı):
    https://github.com/sup3x/claude-code-fable-eco

    İşinize yararsa bir ⭐ bırakmanız yeterli. Projenin tek karşılığı bu.

    Görüş, eleştiri ve benchmark sonuçlarınızı da merak ediyorum.
    hocam bunu claude webde nasıl kullanabiliriz ?
  • 13-08-2026, 13:59:54
    #26
    tiqxe adlı üyeden alıntı: mesajı görüntüle
    İlgi, istek olursa hallederiz
    Codex için de bekliyoruz lütfen 🙏❤️
  • 14-08-2026, 10:07:58
    #27
    Metodolojiyi paylaşman güzel olmuş, sadece iddia değil ham benchmark JSON'larını da repoda bırakman güven veriyor. Biz ajans tarafında agent oturumlarında context şişmesini genelde işi alt görevlere bölerek ve büyük dosyaları tam okutmak yerine ilgili bölümü okutarak kontrol ediyoruz, senin yaklaşımın da benzer bir mantığa dayanıyor gibi görünüyor. Haiku'da tam tersi sonuç çıkması ilginç, muhtemelen daha küçük modelde reasoning kısıtlamasının farklı davranmasından kaynaklanıyor. Repoyu deneyeceğim, eline sağlık.