• 11-03-2026, 01:22:24
    #1
    Merhaba arkadaşlar,
    Uzun süredir üzerinde çalıştığım ve kısıtlı kaynaklarla teknoloji yarışında nasıl bir vizyon ortaya konulabileceğine dair bir referans olması amacıyla geliştirdiğim Cevahir AI & Engine projesini açık kaynak olarak yayınladım.


    Bu proje, yapay zeka yarışında 'biz de varız' demek isteyen Türk gençlerine armağanımdır.


    Kısaca proje şu bileşenleri içeren uçtan uca bir AI altyapısıdır:

    • BPE tokenizer eğitimi ve veri hazırlama pipeline'ı
    • Transformer tabanlı model mimarisi
    • Model eğitim sistemi (training pipeline)
    • Cognitive management (Think / Debate / ToT stratejileri)
    • Chatting ve inference sistemi
    • Modüler AI engine mimarisi

    Proje şu anda 625+ modül dosyası ve 12 ana çatı modülden oluşan geniş bir kod tabanı içeriyor.
    v1 sürümü tamamlanmış olup uçtan uca açık kaynak bir AI engine olarak geliştirme süreci aktif şekilde devam etmektedir.


    Proje Hakkında


    Cevahir, sadece eğitilmiş bir model sunmak yerine; tokenizer eğitiminden bilişsel strateji katmanlarına kadar uzanan tam kapsamlı bir yapay zeka ekosistemini tek bir depoda toplamaktadır. Mevcut pek çok açık kaynak projenin aksine, bu altyapı aşağıdaki bileşenleri entegre şekilde sunar:
    • BPE Tokenizer Eğitimi: Türkçe dil yapısına ve morfolojisine optimize edilmiş özel encoding süreci.
    • Transformer V-4 Mimari: RoPE, SwiGLU ve Flash Attention gibi modern tekniklerle yapılandırılmış modüler sinir ağı.
    • Cognitive Management: Modelin düşünme süreçlerini yöneten (Think, Debate, ToT) bilişsel katman.
    • Bellek Altyapısı: RAG ve Vector DB entegrasyonu için hazır mekanizmalar.


    Vizyon ve Beklentiler


    Bu projeyi, küresel ölçekteki teknoloji tekelleşmesine karşı bir duruş sergilemek ve ülkemizdeki genç geliştiricilere uçtan uca bir mimari referansı sunmak amacıyla paylaştım. Cevahir AI, kendi teknolojisini üretme hayali kuran her bir Türk gencine armağanımdır. Bu noktada sizlerden teknik ve toplumsal bazı destekler beklemekteyim...
    1. Görüş ve Teknik Eleştiri: Projenin mimarisi, modüler yapısı ve kod kalitesi üzerine her türlü teknik analizi konu altında paylaşmanızı rica ederim.
    2. Yaygınlaştırma ve Makale Desteği: Projenin daha geniş kitlelere ulaşması adına, inceleme yazılarınızı veya teknik makalelerinizi farklı forumlarda, haber sitelerinde ve kişisel bloglarınızda yayınlamanız benim için çok kıymetlidir.
    3. Sosyal Medya Desteği: Twitter (X) üzerinde projenin duyurusuyla ilgili tag altına yorum yaparak konunun gündemde kalmasına (topic olmasına) yardımcı olmanız projenin global görünürlüğünü artıracaktır. #cevahirai


    Eğitim Kesitleri ve Çıktılar


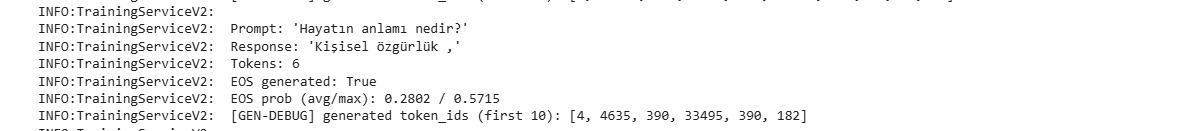
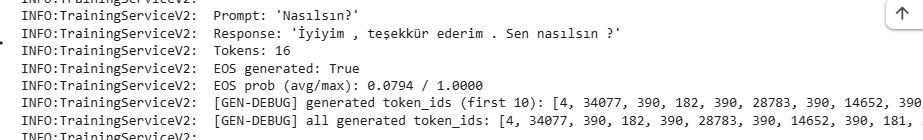
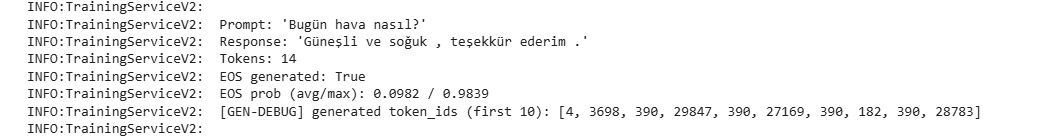
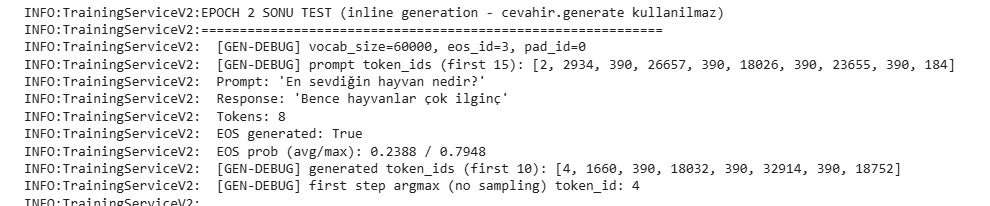
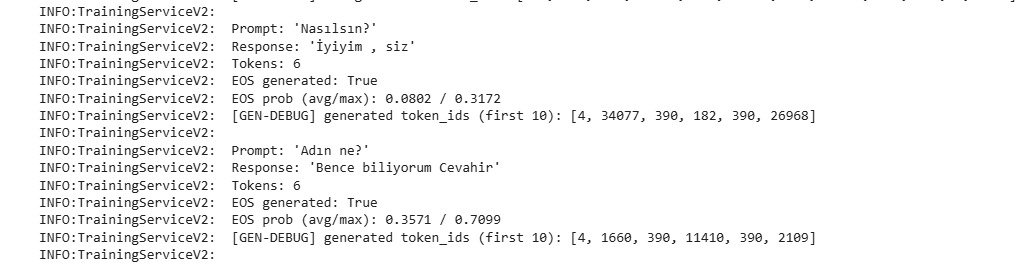
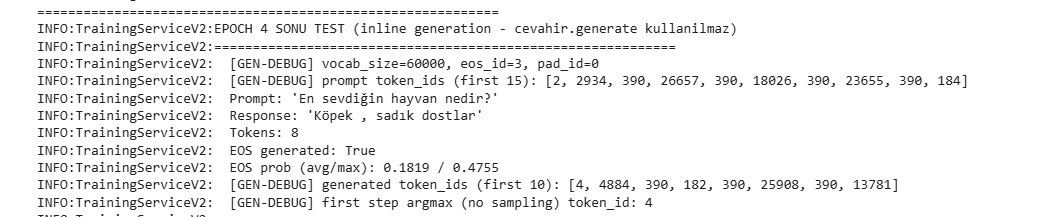
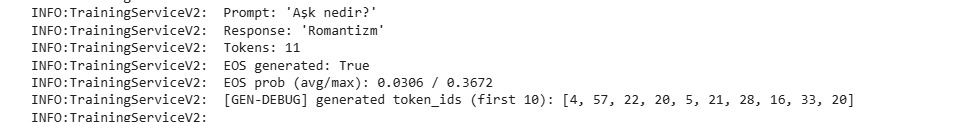
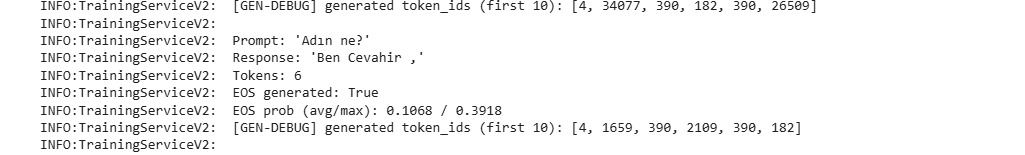
    Aşağıda, modelin eğitim sürecinde TrainingServiceV2 üzerinden alınan gerçek zamanlı inference örneklerini, loss değerlerini ve modelin ürettiği ham çıktıları görebilirsiniz:


    Erişim Bilgileri


    GitHub üzerinden projeyi inceleyebilir, fork’layabilir ve yıldız (star) vererek destek olabilirsiniz: https://github.com/myylogic/cevahir-ai


    Proje tamamen Apache License 2.0 ile lisanslanmıştır. Katkılarınızı ve değerli yorumlarınızı bekliyorum.


    Sosyal Medya Hesaplarım


    İnstagram: https://instagram.com/myylogic
    X: https://twitter.com/myylogic
    Linkedin : https://www.linkedin.com/in/myylogic


    Muhammed Yasin Yılmaz Cevahir AI Geliştiricisi
  • 11-03-2026, 17:19:40
    #2
    Proje yaklaşık 16 aylık bir geliştirme sürecinin ürünü.
    Özellikle tokenizer, training pipeline ve cognitive management mimarisi üzerine teknik eleştiri ve yorumlarınızı merak ediyorum.
    Kod mimarisi hakkında görüşlerinizi paylaşırsanız çok değerli olur..


  • 11-03-2026, 21:55:55
    #3
    Öncelikle elinize emeğinize sağlık. Bu konuya sabah saatlerinde baktım ancak zaman olmadığı için ve üstünkörü geçmek istemediğim için yazacaklarımı biraz beklettim.

    Projeye genel olarak baktığımda mimari anlamda oldukça düşünülmüş bir yapı görüyorum. Tokenizer’dan modele, modelden cognitive katmana ve oradan chat/API tarafına kadar net bir katman ayrımı yapılmış. Bu da projeyi sadece “bir model eğitme denemesi” olmaktan çıkarıp daha çok bir LLM altyapısı gibi konumlandırıyor. Bu açıdan mimari yaklaşım bence güçlü.
    Tokenizer tarafında Türkçe için özel düşünülmüş olması hoşuma gitti. Pretokenizer ve morfoloji katmanları Türkçe dil yapısını dikkate alıyor. Ancak burada küçük bir risk var: sistem biraz fazla kural bazlı çalışıyor gibi. BPE gibi yöntemlerin avantajı aslında bazı örüntüleri veriden öğrenebilmesi. Eğer pretokenization ve morfoloji katmanı çok baskın olursa modelin veriden öğrenebileceği alan daralabilir.

    Training pipeline tarafında model yönetimi, eğitim ve inference'ın ayrılmış olması güzel bir tercih. ModelManager gibi bir katman üzerinden modelin lifecycle'ını yönetmek mantıklı. Ancak bazı yerlerde mimari biraz fazla soyutlanmış gibi hissettirdi. Araştırma aşamasındaki projelerde bazen bu kadar çok manager ve abstraction katmanı geliştirme hızını biraz düşürebiliyor.
    Cognitive management kısmı ise projenin en ilginç tarafı. Direct/think/debate/critic gibi stratejiler fikri oldukça iddialı. Ancak bu tarz katmanların gerçekten faydalı olup olmadığını göstermek için ciddi deneyler gerekiyor. Temel model yeterince güçlü değilse cognitive layer bazen gerçek reasoning üretmekten çok sadece ek karmaşıklık oluşturabiliyor.
  • 11-03-2026, 23:41:52
    #4
    jasgues adlı üyeden alıntı: mesajı görüntüle
    Öncelikle elinize emeğinize sağlık. Bu konuya sabah saatlerinde baktım ancak zaman olmadığı için ve üstünkörü geçmek istemediğim için yazacaklarımı biraz beklettim.

    Projeye genel olarak baktığımda mimari anlamda oldukça düşünülmüş bir yapı görüyorum. Tokenizer’dan modele, modelden cognitive katmana ve oradan chat/API tarafına kadar net bir katman ayrımı yapılmış. Bu da projeyi sadece “bir model eğitme denemesi” olmaktan çıkarıp daha çok bir LLM altyapısı gibi konumlandırıyor. Bu açıdan mimari yaklaşım bence güçlü.
    Tokenizer tarafında Türkçe için özel düşünülmüş olması hoşuma gitti. Pretokenizer ve morfoloji katmanları Türkçe dil yapısını dikkate alıyor. Ancak burada küçük bir risk var: sistem biraz fazla kural bazlı çalışıyor gibi. BPE gibi yöntemlerin avantajı aslında bazı örüntüleri veriden öğrenebilmesi. Eğer pretokenization ve morfoloji katmanı çok baskın olursa modelin veriden öğrenebileceği alan daralabilir.

    Training pipeline tarafında model yönetimi, eğitim ve inference'ın ayrılmış olması güzel bir tercih. ModelManager gibi bir katman üzerinden modelin lifecycle'ını yönetmek mantıklı. Ancak bazı yerlerde mimari biraz fazla soyutlanmış gibi hissettirdi. Araştırma aşamasındaki projelerde bazen bu kadar çok manager ve abstraction katmanı geliştirme hızını biraz düşürebiliyor.
    Cognitive management kısmı ise projenin en ilginç tarafı. Direct/think/debate/critic gibi stratejiler fikri oldukça iddialı. Ancak bu tarz katmanların gerçekten faydalı olup olmadığını göstermek için ciddi deneyler gerekiyor. Temel model yeterince güçlü değilse cognitive layer bazen gerçek reasoning üretmekten çok sadece ek karmaşıklık oluşturabiliyor.

    Öncelikle detaylı inceleyip bu kadar kapsamlı bir geri bildirim yazdığınız için teşekkür ederim.
    Mimari tarafı özellikle “LLM altyapısı” mantığıyla kurgulamaya çalıştım. Amacım yalnızca bir model eğitmekten ziyade tokenizer → training → model → cognitive → chat pipeline akışını tek bir engine mimarisi içinde toplayabilmekti.
    Tokenizer tarafındaki kural bazlı yapı konusunda söylediğiniz noktaya katılıyorum. Türkçe'nin eklemeli yapısı sebebiyle pretokenizer ve morfoloji katmanını biraz daha güçlü tasarladım. Ancak dediğiniz gibi bunun veriden öğrenme kapasitesini daraltmaması için BPE kısmını mümkün olduğunca veri odaklı bırakmaya çalıştım. Bu taraf muhtemelen ilerleyen sürümlerde daha fazla deney gerektirecek.
    Abstraction katmanları konusunda da haklısınız; proje biraz “engine” mantığıyla ilerlediği için manager katmanları fazla görünebiliyor. Ancak uzun vadede farklı modelleri ve pipeline'ları değiştirmeyi kolaylaştırması için bu şekilde modüler kurgulamayı tercih ettim.
    Cognitive management kısmı ise şu an gerçekten deneysel bir alan. Think / Debate / Critic gibi stratejilerin pratikte ne kadar katkı sağlayacağını görmek için eğitim ilerledikçe daha fazla test yapmayı planlıyorum.
    Tekrar zaman ayırıp projeyi incelemeniz gerçekten çok değerli. Özellikle tokenizer ve cognitive katman tarafındaki eleştirileriniz benim için oldukça faydalı oldu.

  • 13-03-2026, 02:50:25
    #5
    başarılar kardeşim
  • 13-03-2026, 12:13:48
    #6
    burakbyndrr adlı üyeden alıntı: mesajı görüntüle
    başarılar kardeşim
    Eyvallah kardeşim. Bu süreçte desteğini hiç eksik etmedin, o yüzden yorumun benim için ayrıca değerli. İnşallah daha büyük işler gelecek.
  • 13-03-2026, 12:57:05
    #7
    Başarılar dilerim hocam, umarım iyi yerlerde görürüz fakat bizim Türk insanı mantığı herzaman yüceltmek yerine ya gömmek ya da çalmak olduğu için değerini ya çok popüler olduğunda ya da globalde ün kazanırsan anlarlar tavsiyem gerçek manada bu işi global pazarda yürütmen olacaktır emeğinin karşılığını ve projeye güvenini daha taze tutacağı kanısındayım 🙏🏻
  • 13-03-2026, 13:05:51
    #8
    ATLASx adlı üyeden alıntı: mesajı görüntüle
    Başarılar dilerim hocam, umarım iyi yerlerde görürüz fakat bizim Türk insanı mantığı herzaman yüceltmek yerine ya gömmek ya da çalmak olduğu için değerini ya çok popüler olduğunda ya da globalde ün kazanırsan anlarlar tavsiyem gerçek manada bu işi global pazarda yürütmen olacaktır emeğinin karşılığını ve projeye güvenini daha taze tutacağı kanısındayım 🙏🏻

    Değerli yorumunuz ve iyi dilekleriniz için teşekkür ederim hocam.
    Açıkçası ben de bu projeyi geliştirirken yalnızca Türkiye için değil, global geliştirici ekosistemi içinde de bir karşılık bulmasını hedefleyerek paylaştım.
    Ancak yine de ülkemizde teknoloji üretmeye çalışan insanların çoğalmasının uzun vadede kültürel olarak da çok şey değiştireceğine inanıyorum.
    Umarım bizden sonra gelen genç geliştiriciler çok daha güçlü şartlarda çok daha büyük projeler ortaya koyabilirler.
    Tekrar teşekkür ederim.