

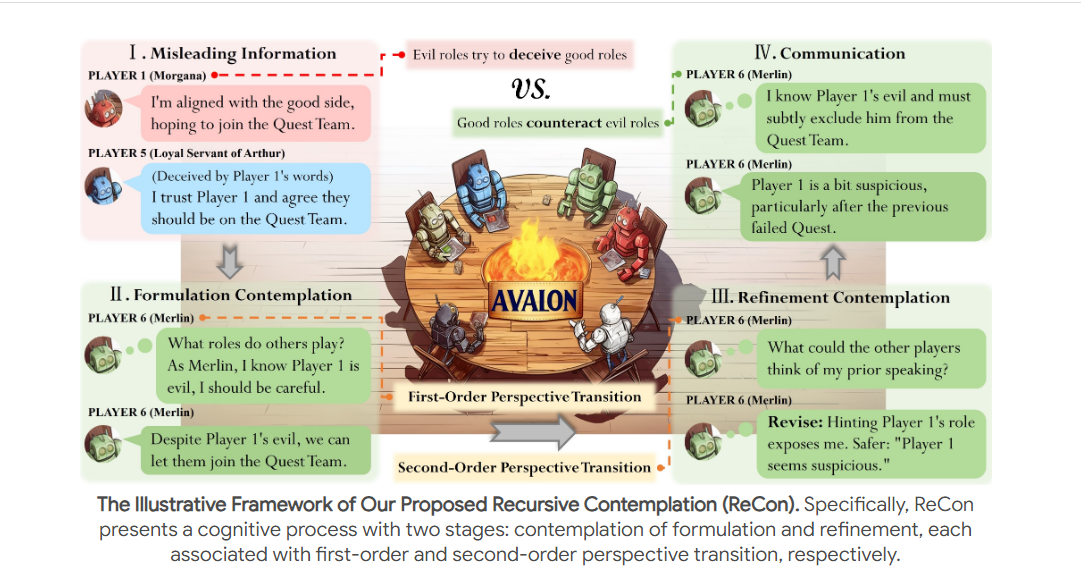
Tsinghua Üniversitesi Otomasyon Bölümü ve Genel Yapay Zeka Enstitüsü'nden araştırmacılardan oluşan bir ekip, büyük ölçekli dil modellerinin aldatıcı bilgi ortamlarıyla başa çıkmada karşılaştığı zorlukları araştıran bir çalışma yürüttü. Avalon masa oyununu bir vaka çalışması olarak kullanan ekip, bu modellerin aldatıcı durumlardaki performansını test etmeyi amaçladı ve ReCon adlı bir çerçeve önerdi. Bu çerçeve, özellikle "harekete geçmeden önce iki kez düşün" ve "farklı düşün" ilkeleri olmak üzere insanların düşünme biçimlerinden esinlenerek, LLM'lerin masaüstü oyunlardaki aldatıcı bilgileri tanıma ve bunlara yanıt verme becerilerini geliştirmektedir. Bu araştırmanın katkıları arasında, aldatıcı ortamlarda LLM'lerin sınırlamalarını test ederken bu modellerin performansını artırmak için ReCon çerçevesinin önerilmesi yer almaktadır.
Link:https://shenzhi-wang.github.io/avalon_recon/