Merhaba arkadaşlar,
n8n üzerinde bir süredir çalışmalar yapıyorum ve oldukça verimli sonuçlar aldım. Video ve görsel üretimi otomasyonları, ses ve müzik otomasyonları, veri işleme ve dönüştürme gibi işler yaptım. Sizlerle de bu deneyimlerimi paylaşmak ve birlikte yeni projeler geliştirmek isterim.
n8n hakkında aklınıza takılan sorular varsa sorabilir, otomasyon fikirleri üzerine birlikte düşünebilir ve birlikte projeler geliştirebiliriz. Ya da n8n ile bir otomasyon yaptırmak istiyorsanız veya bir projeniz var ve bir yerlerde takıldıysanız hem bu başlık altına yazabilir ya da Dm atabilirsiniz. Deneyimlerini paylaşmak isteyen arkadaşları da beklerim.
N8N Otomasyonları İşbirliği & Bilgi Paylaşımı
36
●2.164
- 17-10-2025, 00:38:18n8n workflow builder geliyor. sağ tarafta asistan çıkıyor. oraya otomasyonunu oluşturmak istediğiniz senaryoyu yazıyorsunuz o bir kaç dakika içinde oluşturuyor.
örneğin, n8n form üzerinden ekleyeceğim keyword listeki anahtar kelimeleri,xx api ile xx modeli kullanarak başlık, açıklama hashtag oluşturup, xx api ile xx image modeli kullanarak görsel oluşturup, günde 4 kez şu saatte başlamak üzere 6 saat arayla pinterest hesabıma pinleyen workflowu oluştur yazıyorsun o kendi oluşturuyor.
- 17-10-2025, 01:38:58Cloud sürümüne çıkarmışlar. ileride self hosted'lara da bu özelliği ekleyecez diyorlar. Hızlıca workflow'u kurmak için işe yarar.mesutsahin adlı üyeden alıntı: mesajı görüntüle
Bu arada ufaktan paylaşım yapayım ben de.
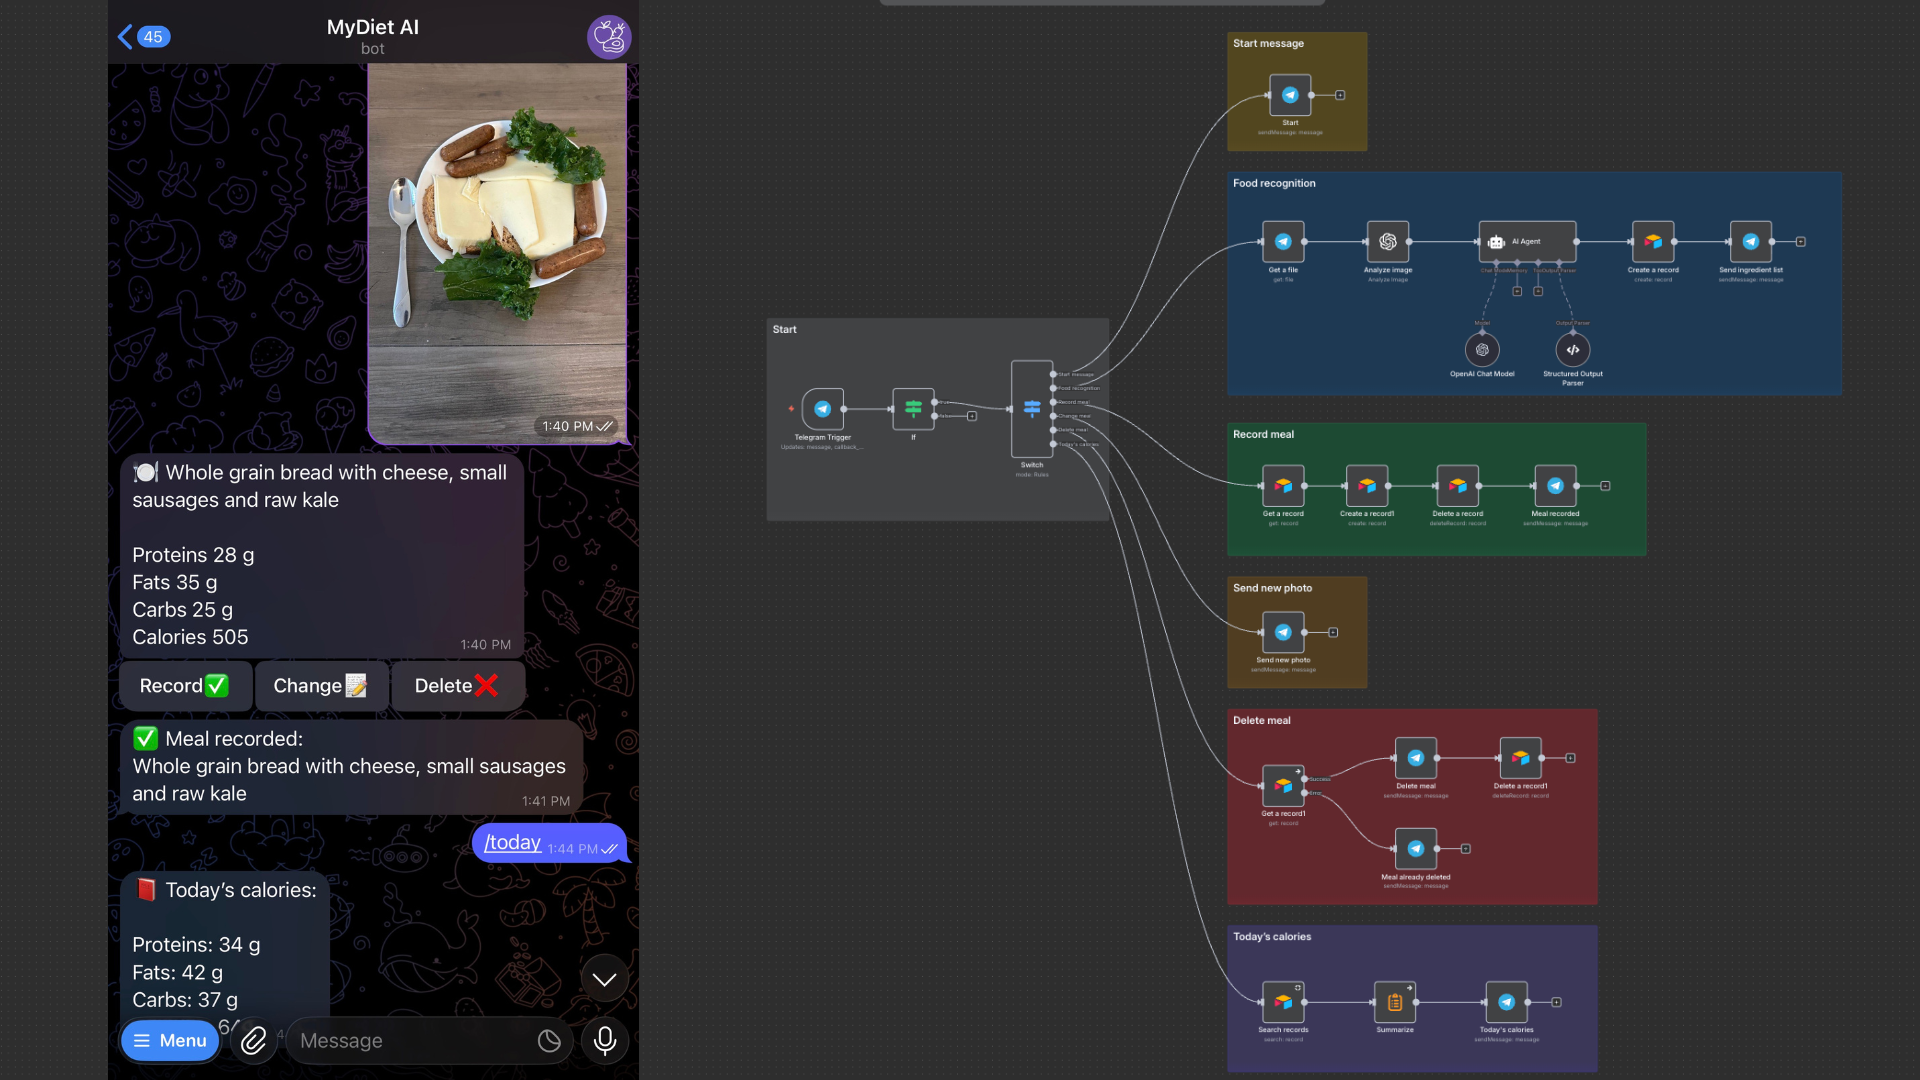
Bir ara ünlü olan resimden kalori tahmini yapan uygulama yapmak isterseniz bu workflow'u kullanabilirsiniz.
https://drive.google.com/file/d/1uIu...NjIMTULqQ/view

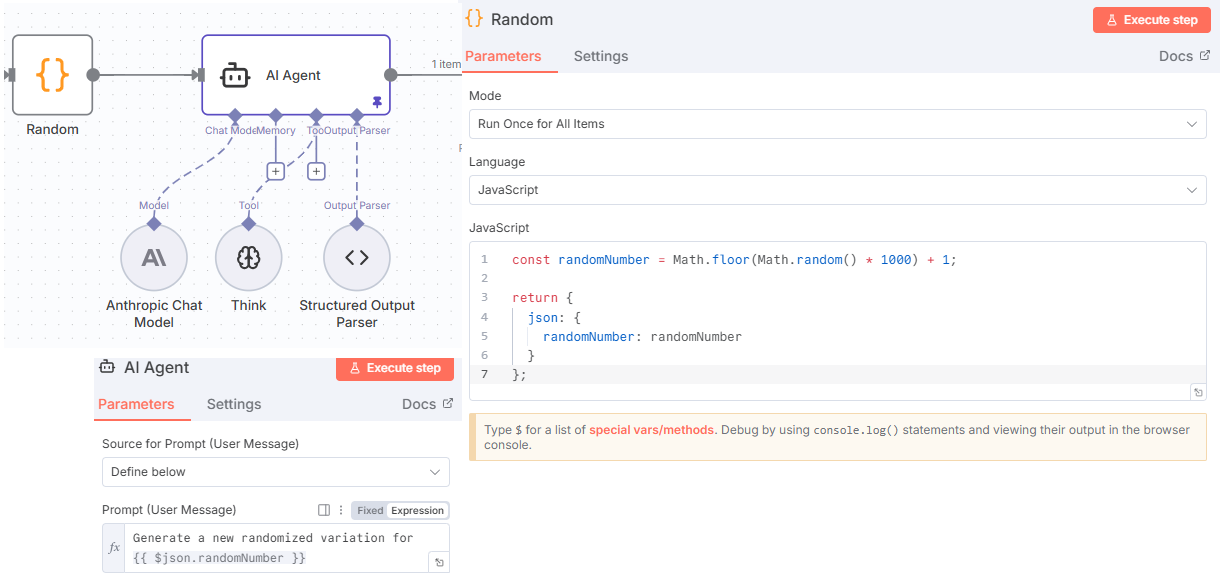
- 17-10-2025, 11:51:59AI Agent'larınızdan her seferinde farklı ve yaratıcı sonuçlar almak istiyorsanız random sayı ekleyin.
Nasıl Çalışır?- AI Agent'ınızdan önce bir Code node ekleyin
- Bu kodu kullanın:
const randomNumber = Math.floor(Math.random() * 1000) + 1;
return { json: { randomNumber: randomNumber } };
3. AI Agent'ın User Prompt'una bunu ekleyin:
Neden İşe Yarar?Alıntı
LLM'ler aynı prompt'a genellikle benzer cevaplar verir. Random sayı ekleyerek her çalıştırmada farklı bir "düşünme yolu" tetiklemiş olursunuz.
Hangi Durumlarda Kullanılır?
✅ Görsel üretim prompt'ları (farklı kıyafet, stil, renk kombinasyonları)
✅ Yaratıcı içerik üretimi (farklı yazı tarzları, perspektifler)
✅ A/B test senaryoları
✅ Problem çözümünde alternatif yaklaşımlar
Not: Tutarlı, tekrarlanabilir sonuçlar istiyorsanız bu yöntemi kullanmayın!
- 17-10-2025, 13:55:09İlk başlarda otomasyonları geliştirirken aşırı derecede token maliyeti harcadıktan sonra, token optimizasyonunu ciddiye almak zorunda kaldım. Bu önerilerimi denerseniz hem maliyetiniz düşer hem de workflow performansı artar.
Mesela email'leri ayrıştıran bir akışımız olduğunu düşünelim:
1. Modüler Agent Mimarisi
Çoğu kişinin yaptığı hata: Her şeyi yapan devasa bir ai agent oluşturmak. Mailin analizini, sınıflandırmasını, biçimlendirmesini ve çıktı üretimi tek bir 0.15$'lık request'te yapar.
Doğru yaklaşım: Karmaşık görevleri mikro agent'lara bölmek.
----
Tek Agent ile yaptığımızda prompt'u böyle yazarız: "Bu e-postayı analiz et, 1) önceliğini belirle, 2) önemli bilgileri çıkar, 3) yanıtı json formatında dön"
Maliyet: 0.15$ × 1000 email = 150$
Mikro agent mimarisi ile yaparsak:
Agent 1: "Bu acil mi? Evet/Hayır" -> (gpt-3.5-turbo, 0.02$)
Agent 2: "Göndereni, konuyu ve mail özetini çıkar" -> (gpt-4o-mini, 0.03$)
Agent 3: "JSON biçiminde yaz" → (gpt-3.5-turbo, 0.01$)
Toplam: 0.06$ x 1000 email = 60$
Neden işe yarıyor: Her Agent, sadece kendi görevine uygun en ucuz modeli kullanıyor. Ayrıca, bir adım başarısız olursa sadece o kısmı yeniden çalıştırırsınız; tüm analizi değil. Modüler Agentlar ayrıca hata ayıklamak, test etmek ve bağımsız olarak geliştirmek açısından da daha kolaydır.
2. Token Preprocessing Tekniği
Sorun: Ham ve şişmiş veriyi modele vermek, içindeki gereksiz textler yüzünden gereksiz token tüketir.
Çözüm: Verinizi AI'a gitmeden önce temizleyin.
3 adımlı preprocess hattım:
Adım 1: Gereksiz alanları kaldır
// AI öncesi eklediğim node
const cleanData = items.map(item => ({
  content: item.body,           // Tut
  timestamp: item.created_at,   // Tut
  priority: item.priority       // Tut
  // metadata, internal_ids, biçimlendirme vs. gibi alanları almadım
}));
Adım 2: Model yönlendirme için sınıflandırma
// Uzunluğua göre uygun modele yönlendirme
if (item.content.length > 4000) {
  return { model: "gpt-4-turbo", data: item };
} else {
  return { model: "gpt-3.5-turbo", data: item };
}
Adım 3: Mümkünse özetle
Uzun belgelerde önce ucuz bir özetleme aşaması kullanın:
Normalde: Ham 2000 kelimelik belgeyi oku -> Ana AI Agent'a bağla
Özetleme Aşaması Eklersek: Ham 2000 kelimelik belgeyi oku -> "100 kelimede ana noktaları çıkar" -> Ana AI Agent'a bağla
Sonuç: Ortalama token sayısı 3.500'den 1.200'e indi.
Maliyet: request başına 0.10$ -> 0.035$
3. Batch İşleme
Yeni başlayanların hatası: Her öğeyi tek tek işlerler ve her seferinde sistem promptunu tekrar gönderirler.
Optimize Yöntem: Birden çok öğeyi tek seferde toplu olarak işleyerek sistem prompt maliyeti azaltılır.
Basit matematik:
Sistem promptu: 200 token
10 öğeyi ayrı ayrı işlemek: 200 × 10 = 2000 token boşa gider
10 öğeyi tek partide işlemek: 200 × 1 = 200 token
Kaç öğeyi bir batch'te çalıştırmanız gerektiği, verinizin yapısına ve kullandığınız modele bağlıdır.
4. JSON Çıktıya Zorlama
Çok adımlı workflowlarda yapılandırılmış çıktı, doğal dilden çok daha verimlidir.
Optimize Edilmemiş Yöntem:
AI çıktısı: "Konuda başlığında 'ACİL' geçtiği ve gönderen patron olduğu için e-posta acil görünüyor..."
Token: ~150
Sonraki Agent: Bu açıklamayı tamamen ayrıştırmak zorunda.
Öptimize Edilmiş Yöntem:
AI çıktısı: {"aciliyet": "yüksek", "sebep": "patron isteği", "yonlendirme": "destek"}
Token: ~25
Sonraki Agent: Temiz ve yapılandırılmış veri alır.
Bunu Nasıl yapacağım?
Sistem promptu: "Output Format MUST be STRICT JSON object ONLY no markdown, no code blocks, no extra text, no explanations.
Keys MUST be exactly: "aciliyet" (for priority), "sebep" (for mail category), "yonlendirme" (for department)
Do not add any other keys or fields."
Kullanıcı promptu: "Analyze email: [content]"
Böylece sonraki Agent, bu yapılandırılmış veriyi çok daha hızlı ve ucuz işler.
5. Token Takibi Yapın
Kabus senaryosu: AI Agent'ınız kontrolden çıkar ve bir gecede 500$ fatura oluşturur.
Çözüm: Her AI nodunda maliyet takibi yapın.
Takip ettiklerim:
Her çalıştırmadaki token sayısı
İş akışı başına maliyet
Günlük/aylık harcama limitleri
Model performans ölçümleri
6. Daha Ucuz Modeller için Prompt Mühendisliği
Doğru prompt ile çoğu görev gpt-5 yerine gpt-5-mini üzerinde çalışabilir.
Model düşürme sürecim: İstediğim kaliteyi elde edene kadar gpt-5 ile üretiyorum. O çıktıyı örnek alıp aynı sonucu almak için gpt-5-mini'ye uygun prompt yazıyorum.
Örnek dönüşüm:
Orijinal (gpt-5):
"Bu müşteri yorumunu analiz et ve önerini yaz."
Optimize edilmiş (gpt-5-mini):
"Bir müşteri destek analisti gibi davran. Şu formatta yanıt ver:
DUYGU: [Pozitif/Negatif/Nötr]
ONEMLI_DURUMLAR: [madde madde listele, en fazla 3]
ONEM: [Yüksek/Orta/Düşük]
AKSIYON: [belirli sonraki adım]
Örnek:
DUYGU: Negatif
ONEMLI_DURUMLAR:
Yavaş yanıt süresi
Karmaşık arayüz
Eksik özellik
ONEM: Yüksek
AKSIYON: Ürünü geliştirme ekibine 24 saat içinde ilet.
Şimdi analiz et: [yorum]"
Sonuç: Görevlerin %85'i artık gpt-5-mini'de, maliyetin 1/10'u fiyatına çalışıyor.
7. Dinamik Model Seçimi
Ucuz bir modelle içeriğin karmaşıklığını belirleyin, sadece gerektiğinde pahalı modele yönlendirin.
İki aşamalı yönlendirme sistemi:
Adım 1: Karmaşıklık Değerlendirmesi
Komut:
"Karmaşıklığı 110 arasında puanla: [içerik]"
Model: gpt-5-mini ($0.001)
Çıktı: Sadece bir sayı
Adım 2: Dinamik Yönlendirme(code node ile)
if (complexity <= 3) {
  return { model: "gpt-5-nano" };   // $0.001
} else if (complexity <= 7) {
  return { model: "gpt-5-mini" };   // $0.01
} else {
  return { model: "gpt-5" };        // $0.1
}
Sonuç: İşlerin %70'i en ucuz modelde, %20'si orta seviye, %10'u premium modelde çalışıyor.
Ek ipucu: OpenRouter'ın model yönlendirme API'sini kullanarak, kalite eşiğinizi karşılayan en ucuz modeli otomatik seçebilirsiniz. - 17-10-2025, 13:57:21hizmet olarak kullanırsanız deneme sürümü var. ama kendi makinanızda sınırsız ve ücretsiz kullanabilirsiniz.IraArel adlı üyeden alıntı: mesajı görüntüle
- 18-10-2025, 12:10:48Çok hoç bir konu uplayalım.
1-2sene içinde forumda bu tür konuları bol bol göreceğimize inanıyorum